 Bayu Permadi
Membangun Keandalan Sistem yang Sebenarnya untuk Bisnis Anda
Bagi seorang Head of Engineering atau CTO, tekanan untuk menyajikan angka uptime yang sempurna kepada pelanggan sering kali berujung pada kompromi yang berbahaya. Banyak organisasi terjebak dalam janji pemasaran tanpa terlebih dahulu menentukan sla internal realistis yang didasarkan pada kapasitas nyata tim dan infrastruktur mereka. Memaksakan komitmen keandalan tinggi (High Availability) tanpa fondasi internal yang solid ibarat membangun gedung pencakar langit di atas pasir hisap. Saat terjadi downtime, dampaknya bukan sekadar gangguan teknis, melainkan degradasi kepercayaan pelanggan yang telah dibangun bertahun-tahun serta potensi penalti finansial yang signifikan. Oleh karena itu, langkah pertama dalam merancang strategi keandalan yang berkelanjutan adalah menyelaraskan ekspektasi bisnis dengan kenyataan operasional di level engineering.
Mengapa Angka Sembilan Sering Menjadi Jebakan Reputasi Bisnis
Dalam dunia komputasi awan, kita sering mendengar janji manis tentang “four nines” atau 99.99% uptime. Namun, di balik angka tersebut terdapat konsekuensi operasional yang luar biasa berat karena toleransi downtime kumulatif hanya sekitar 52 menit dalam setahun. Kegagalan memahami implikasi operasional ini sering kali disebabkan oleh kurangnya transparansi antara tim produk yang menginginkan daya saing pasar dan tim engineering yang mengelola keterbatasan sistem. Tanpa upaya serius untuk menentukan sla internal realistis, janji eksternal tersebut hanyalah sebuah bom waktu yang menunggu saat yang tepat untuk meledak. Kita harus berani melihat ke dalam dan mengukur metrik keandalan secara jujur sebelum mempublikasikannya ke luar.
Realitas di Balik Layar Infrastruktur Modern
Infrastruktur modern yang sangat terdistribusi saat ini membawa kompleksitas baru yang membuat pencapaian keandalan tinggi semakin menantang. Ketergantungan pada API pihak ketiga, jaringan mikroservis yang rumit, hingga latensi database adalah variabel-variabel yang sering kali berada di luar kendali penuh tim operasional Anda. Jika Anda menjanjikan SLA eksternal yang agresif tanpa memperhitungkan variabel-variabel eksternal ini, Anda sedang merancang skenario kegagalan bagi tim Anda sendiri. Di sinilah pentingnya memiliki visi strategis yang mengutamakan ketahanan sistem (resiliency) daripada sekadar mengejar angka teoretis di atas kertas.
Mengapa Uptime dan Kepuasan Pengguna Adalah Dua Sisi Mata Uang yang Sama
Menjembatani kesenjangan antara janji pemasaran dan kapabilitas teknis memerlukan pemahaman mendalam tentang bagaimana keandalan sistem berdampak langsung pada retensi pelanggan dan kesehatan finansial perusahaan. Ketika sistem mengalami gangguan, kerugian nyata tidak hanya dihitung dari hilangnya transaksi langsung pada menit tersebut, melainkan juga dari produktivitas tim yang terserap untuk melakukan pemadam kebakaran (firefighting) alih-alih fokus pada inovasi produk. Untuk membangun strategi pertahanan yang kokoh, para pengambil keputusan teknologi harus beralih dari sekadar memantau ketersediaan server secara mentah menjadi memantau pengalaman pengguna yang sebenarnya.
Menghubungkan Keandalan Sistem dengan Metrik Bisnis Nyata
Uptime yang tinggi bukan sekadar tujuan teknis, melainkan pilar utama yang menopang kepuasan pelanggan dan reputasi brand. Ketika kita berhasil menentukan sla internal realistis, kita secara tidak langsung memberikan ruang bernapas bagi tim engineering untuk melakukan iterasi produk dengan aman tanpa rasa takut yang konstan terhadap kegagalan sistem. Keandalan yang terukur secara internal memungkinkan manajemen membuat keputusan investasi teknologi yang lebih bijaksana, misalnya kapan harus memprioritaskan perbaikan bug dan stabilitas sistem dibandingkan merilis fitur baru. Penyelarasan ini memastikan bahwa setiap rupiah yang dikeluarkan untuk infrastruktur berkontribusi langsung pada retensi pelanggan jangka panjang.
Anatomi Service Level Objective (SLO) dan Service Level Indicator (SLI)
Sebelum kita melangkah lebih jauh ke dalam komitmen hukum berupa SLA, kita harus terlebih dahulu menguasai konsep dasar Service Level Indicator (SLI) dan Service Level Objective (SLO). SLI adalah metrik spesifik yang mengukur kinerja layanan, seperti latensi atau tingkat keberhasilan request, sedangkan SLO adalah target target kinerja yang disepakati secara internal berdasarkan SLI tersebut. Konsep ini dijelaskan secara mendalam dalam panduan industri seperti Google SRE Book yang menjadi referensi global dalam mengelola keandalan sistem skala besar. Dengan memahami hubungan harmonis antara SLI, SLO, dan SLA, organisasi Anda dapat menghindari perdebatan subjektif saat terjadi insiden dan beralih ke pengambilan keputusan yang berbasis data konkret.
Menyeimbangkan Keandalan, Biaya, dan Risiko Operasional
Setiap perusahaan menginginkan sistem yang selalu aktif dan responsif di setiap detik. Namun, keinginan ini harus diimbangi dengan kesadaran bahwa keandalan ekstra membutuhkan biaya investasi yang eksponensial. Memilih tingkat keandalan yang tepat adalah latihan keseimbangan antara biaya infrastruktur, alokasi sumber daya manusia, dan toleransi risiko bisnis. Di sinilah letak peran kepemimpinan teknologi untuk memandu organisasi menuju jalur yang paling efisien namun tetap tangguh dalam menghadapi ketidakpastian operasional.
Langkah Taktis dalam Menentukan SLA Internal Realistis
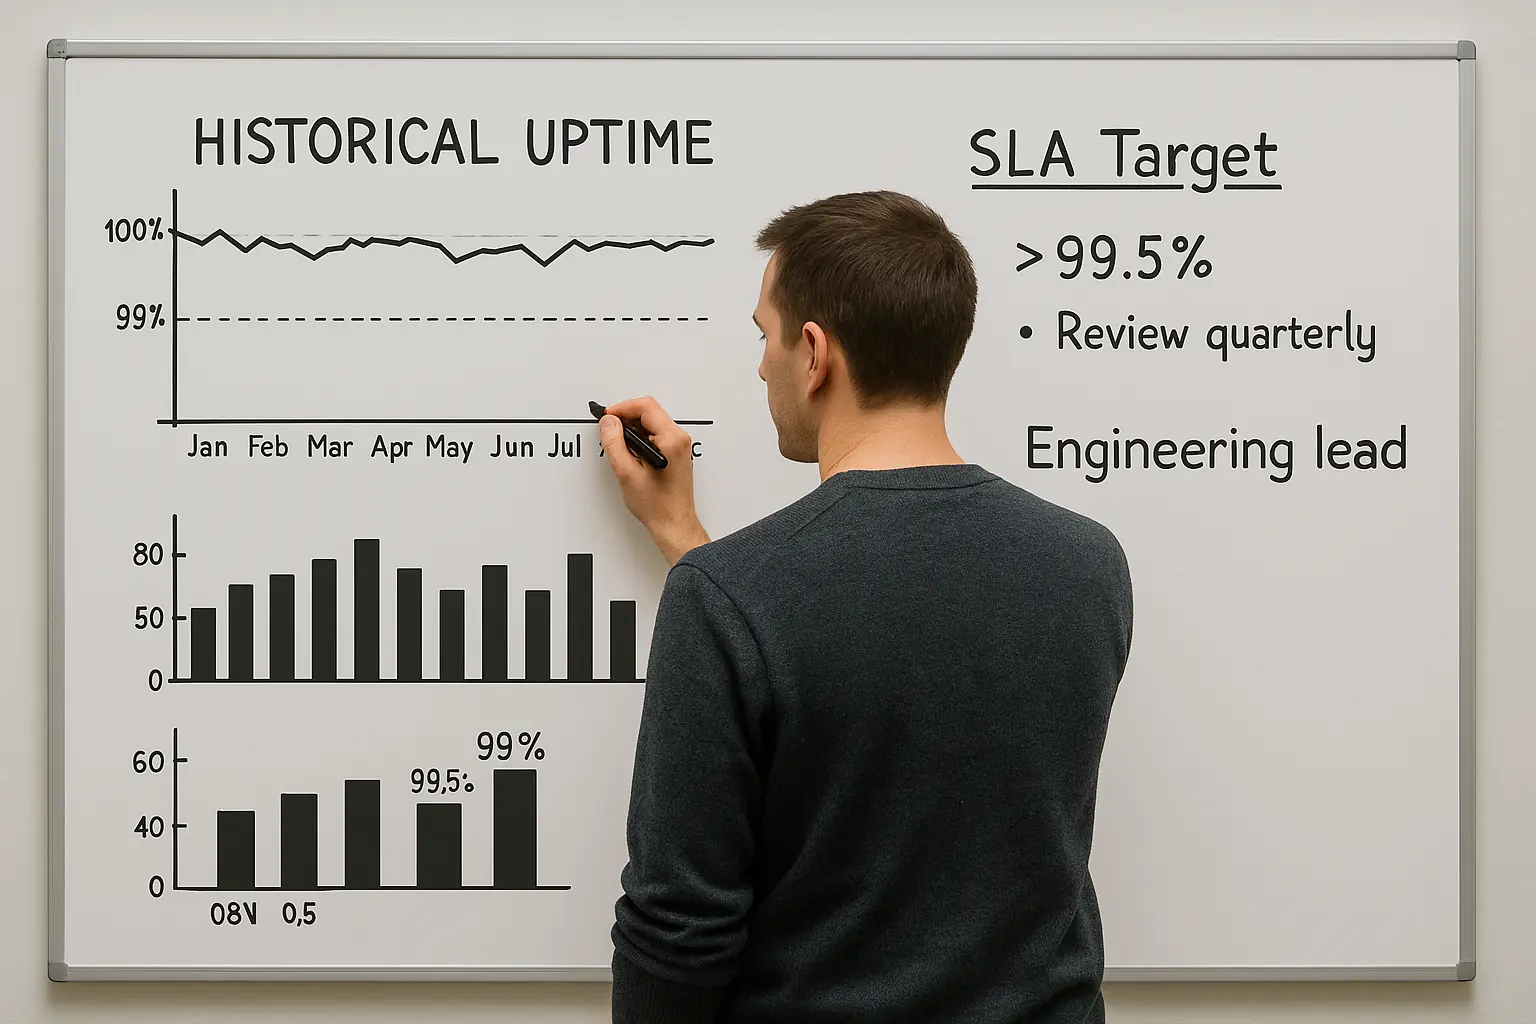
Proses untuk menentukan sla internal realistis dimulai dengan melakukan audit menyeluruh terhadap performa historis sistem Anda selama enam hingga dua belas bulan terakhir. Dari data historis ini, tim dapat mengidentifikasi pola kegagalan, waktu rata-rata untuk deteksi (MTTD), dan waktu rata-rata untuk pemulihan (MTTR) yang sebenarnya terjadi di lapangan. Selanjutnya, tentukan apa yang disebut dengan “Error Budget”—jumlah kegagalan yang dapat ditoleransi oleh sistem dalam periode tertentu sebelum pengalaman pengguna mulai terganggu secara signifikan. Jika Error Budget Anda hampir habis, tim harus secara otomatis menghentikan perilisan fitur baru dan fokus sepenuhnya pada peningkatan stabilitas sistem guna menjaga batas SLA yang aman.
Membangun Arsitektur High Availability Tanpa Menguras Anggaran
Mencapai High Availability tidak selalu berarti Anda harus menduplikasi seluruh infrastruktur Anda dan melipatgandakan biaya cloud bulanan secara tidak rasional. Strategi yang lebih cerdas adalah mengidentifikasi komponen kritis dari aplikasi Anda yang benar-benar membutuhkan redundansi tinggi, sedangkan komponen non-kritis dapat berjalan dengan arsitektur yang lebih sederhana. Melalui pendekatan zonasi risiko ini, Anda dapat merancang strategi Disaster Recovery (DR) yang efisien, di mana pemulihan data diprioritaskan pada alur transaksi utama yang paling sensitif terhadap downtime. Hasilnya adalah sistem yang tangguh dengan efisiensi biaya yang tetap terjaga secara optimal.
Kolaborasi Strategis untuk Mengamankan Masa Depan Infrastruktur Anda
Menentukan dan menerapkan keandalan sistem bukanlah proyek satu kali selesai, melainkan sebuah proses penyempurnaan berkelanjutan yang memerlukan keahlian mendalam serta alat pemantauan yang tepat. Bagi perusahaan yang sedang bertumbuh pesat, mengelola kompleksitas ini secara mandiri sering kali mengalihkan fokus berharga dari pengembangan bisnis inti Anda. Bermitra dengan spesialis infrastruktur cloud yang memahami seluk-beluk keandalan sistem adalah langkah strategis terbaik untuk mempercepat pencapaian target bisnis Anda tanpa risiko operasional yang tinggi.
Menyelaraskan Tim Operasional dengan Masa Depan Bisnis Anda
Kami di Pandawa Cloud .Net memahami bahwa di balik setiap baris kode dan server yang berjalan, ada janji bisnis yang harus Anda penuhi kepada pelanggan Anda. Pendekatan kami sebagai penasihat strategis difokuskan pada membantu Anda merancang arsitektur cloud yang tidak hanya andal secara teknis, tetapi juga masuk akal secara finansial dan operasional. Dengan membiarkan para ahli mengelola kompleksitas infrastruktur, tim engineering Anda dapat kembali fokus pada hal yang paling penting: membangun inovasi produk yang mendorong pertumbuhan bisnis secara eksponensial.
Langkah Pertama Menuju Infrastruktur yang Terbimbing dan Andal
Jangan biarkan reputasi bisnis Anda dipertaruhkan oleh janji uptime yang tidak didukung oleh fondasi internal yang kuat. Memulai perjalanan ini tidak harus rumit atau menakutkan jika Anda memiliki mitra yang tepat di sisi Anda untuk membantu menentukan sla internal realistis. Hubungi tim ahli kami di Pandawa Cloud .Net hari ini untuk mendiskusikan bagaimana kami dapat membantu mengaudit infrastruktur Anda saat ini, merancang strategi keandalan yang disesuaikan dengan kebutuhan bisnis Anda, dan membangun fondasi teknologi yang siap mendukung pertumbuhan masa depan Anda dengan penuh rasa percaya diri.